Meta ha costruito un modello aperto da 1,5 terabyte
Meta presenta Muse Spark Open, modello open-weight da 1,5 TB e 816 miliardi di parametri, ma il fine-tuning richiede 64 GPU H100.
Il modello ha 816 miliardi di parametri e un checkpoint da 1,5 terabyte: per il fine-tuning servono 64 GPU H100
Un modello aperto il cui checkpoint occupa circa 1,5 terabyte. Basta questo numero per capire dove sta il nodo di Muse Spark Open, il modello open-weight che Meta ha presentato il 15 ottobre, una settimana fa, e che il blog di Hugging Face dedicato al lancio descrive in ogni dettaglio tecnico. Non è più una notizia dell’ultima ora, e proprio per questo vale la pena rileggerla a freddo, lontano dall’entusiasmo dei primi giorni. Dietro l’annuncio c’è una contraddizione che riguarda tutto il settore. Gli Stati Uniti dominano la frontiera assoluta dell’intelligenza artificiale, mentre nel campo dei modelli che chiunque può scaricare a dettare legge sembrano essere i laboratori cinesi.
Il primato che l’America non aveva
Partiamo dalla frontiera. Secondo l’analisi di Epoch AI sul confronto tra Stati Uniti e Cina, dal 2023 ogni modello all’avanguardia delle capacità, misurato con l’Epoch Capabilities Index, è stato sviluppato negli Stati Uniti. Su questo terreno la leadership americana regge da anni senza eccezioni.
Nel mondo dei modelli open-weight il quadro però si rovescia. Come osserva un rapporto di policy di Stanford HAI, dopo anni di ritardo i modelli cinesi, e in particolare gli LLM open-weight, sembrano aver raggiunto o perfino superato le controparti globali, sia per capacità sia per adozione. Chi oggi cerca un modello potente da scaricare, modificare e far girare sui propri server ha buone probabilità di trovarne uno cinese. Perché Meta si muove proprio adesso? La risposta più semplice è che il terreno dei modelli aperti, dove l’azienda era stata a lungo un riferimento, le stava scivolando via. Hugging Face definisce Muse Spark Open «il modello open-weights statunitense più capace fino ad oggi». È una formula forte, ma va guardata da vicino: cosa c’è davvero dentro quella definizione?
Aperto, ma per chi?
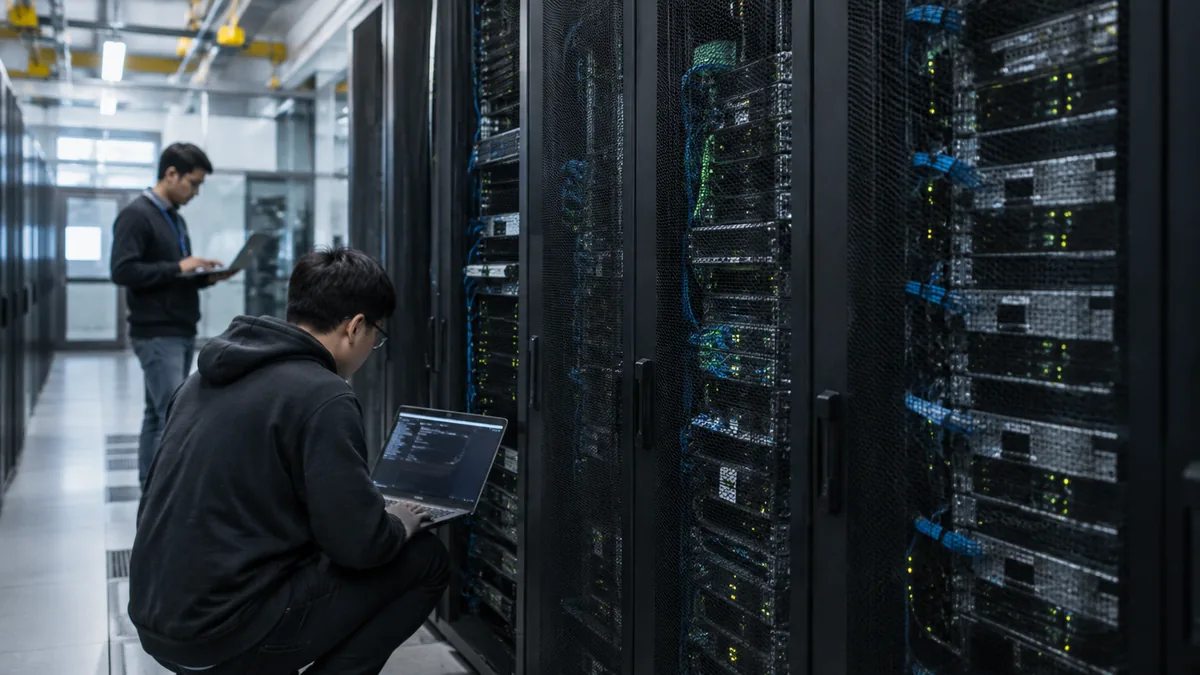
Guardiamo il modello pezzo per pezzo. Muse Spark Open è un modello mixture of experts (MoE) che integra testo, immagini, audio e video. Ha circa 816 miliardi di parametri totali, di cui circa 42 miliardi attivi per ogni token, e una finestra di contesto che arriva fino a un milione di token. Ogni blocco MoE contiene 256 esperti e un router ne seleziona 8 per ciascun token. L’architettura è pensata per contenere il costo di calcolo: a ogni passaggio lavora solo una piccola frazione della rete. Il guadagno però riguarda il calcolo, non la memoria. Per far girare il modello tutti quegli esperti devono restare caricati, e il checkpoint in formato BF16 occupa circa 1,5 TB in safetensors. Non è un file da scaricare sul portatile per una prova nel fine settimana.
Meta, dal canto suo, presenta Muse Spark Open come un modello ottimizzato per il coding, addestrato su flussi di lavoro reali degli sviluppatori: refactoring che coinvolgono più file e lunghe sessioni di debugging. Il pubblico di riferimento, almeno nelle intenzioni dichiarate, sono quindi i programmatori. Resta da capire quali programmatori.
Il dato più rivelatore viene dallo stesso blog di Hugging Face, che ha provato a personalizzare il modello. Il fine-tuning con la tecnica LoRA tramite la libreria TRL è stato eseguito su 64 GPU NVIDIA H100 per 500 step. Ha richiesto circa due ore, a circa 8.000 token al secondo. Il risultato tecnico è buono: l’accuratezza media dei token è salita dal 72% all’84% e la loss è scesa da 1,26 a 0,57, segnali di un addestramento riuscito. Il punto però è un altro. Per ottenere quel risultato servono 64 H100, cioè un’infrastruttura da data center. I pesi sono pubblici, ma chi può davvero modificarli? Una grande azienda, un laboratorio ben finanziato, un fornitore cloud. Per una startup, un ricercatore universitario o uno sviluppatore indipendente, “aperto” rischia di significare soprattutto “consultabile”. Se l’adozione premia ciò che si può far girare e adattare con risorse ragionevoli, la scala di Muse Spark Open diventa un ostacolo prima ancora che un vantaggio.
Nove mesi per inseguire
Poi c’è la questione del tempo. In un annuncio pubblicato sul proprio sito, Meta ha raccontato che Meta Superintelligence Labs ha ricostruito da zero lo stack AI dell’azienda in nove mesi. È uno sforzo enorme, che vale la pena confrontare con un altro numero. Secondo Epoch AI, i modelli cinesi inseguono le capacità statunitensi con un ritardo medio di circa sette mesi, che nei casi migliori scende a quattro e nei peggiori arriva a 14. Il vantaggio americano esiste, ma si misura in mesi, non in anni.
Quanto conta un vantaggio così breve in un mercato dove vince chi viene scaricato e chi diventa la base su cui altri costruiscono? Essere il modello aperto statunitense più potente è un titolo che si può rivendicare. Rischia però di contare poco se l’adozione, il terreno su cui i modelli cinesi sembrano già avanti, finisce per premiare modelli più leggeri e più facili da modificare. Muse Spark Open dimostra che gli Stati Uniti sanno costruire un modello aperto di frontiera. Non dimostra ancora che qualcuno, fuori dai grandi data center, lo userà davvero. Meta ha costruito un modello aperto o un monumento aperto, ammirato da tutti ma alla portata di pochi?